
 Test acouphène
 Test auditif


Être rappelé
Être rappelé
Demandez un rendez-vous
« * » indique les champs nécessaires
Phonak Audéo EON : le nouvel appareil auditif à intelligence artificielle
24.08.2026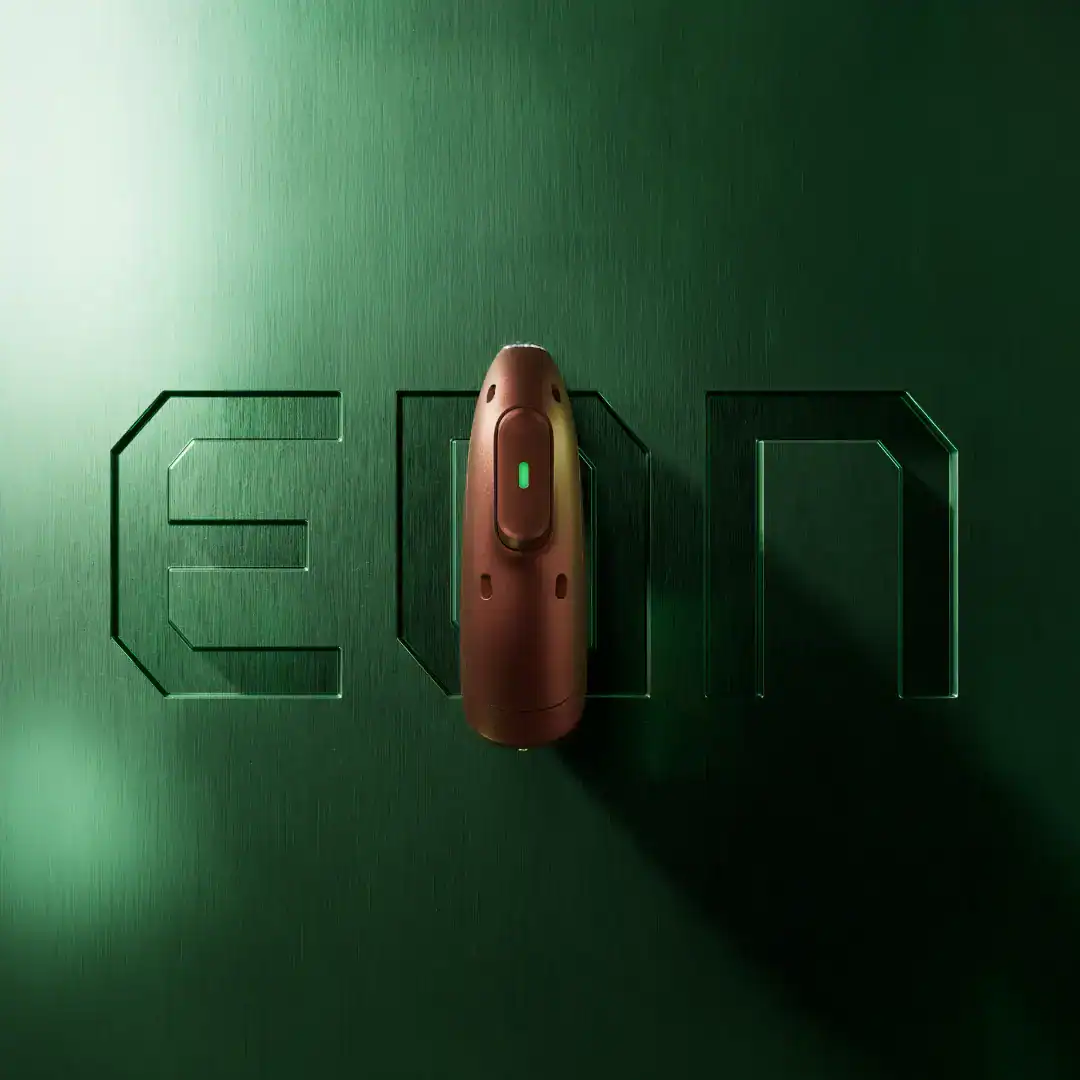
Phonak a lancé le 24 août 2026 Audéo EON, sa nouvelle plateforme d’appareils auditifs à écouteur déporté. La gamme repose sur une puce dédiée à l’intelligence artificielle, HYPERSONIC, qui fait fonctionner la troisième génération du traitement neuronal Spheric Speech Clarity tout en consommant moins d’énergie. Le lancement commence aux États-Unis, la France étant annoncée pour la mi-septembre 2026. Cette page fait le point sur ce qui est réellement documenté, sur ce qui relève encore des données constructeur, et sur ce que cela change concrètement pour une personne appareillée.
Ce que Phonak annonce avec Audéo EON
Le 24 août 2026, Sonova a officiellement annoncé le lancement du portefeuille Phonak Audéo EON, une nouvelle génération de contours d’oreille à écouteur déporté, ou RIC pour receiver-in-canal.
La gamme comprend trois références principales :
- Phonak Audéo EON Sphere, qui intègre le traitement neuronal Spheric Speech Clarity 3.0 ;
- Phonak Audéo EON R, qui bénéficie d’AutoSense OS AI 8.0 mais ne dispose pas de la puce HYPERSONIC dédiée à Spheric Speech Clarity 3.0 ;
- Phonak CROS EON R, destiné aux surdités unilatérales lorsque l’oreille atteinte ne peut pas bénéficier d’une amplification conventionnelle.
Phonak présente EON comme la réunion de deux systèmes d’intelligence artificielle fonctionnant en parallèle : Spheric Speech Clarity 3.0, réservé au modèle Sphere, qui sépare la parole du bruit ; et AutoSense OS AI 8.0, présent sur toute la plateforme, qui analyse l’environnement sonore et active automatiquement la combinaison de réglages adaptée. La distinction est importante : EON R n’est pas un appareil « sans IA », il ne possède simplement pas le processeur neuronal dédié.
Audéo EON Sphere et Audéo EON R sont annoncés pour des pertes auditives légères à profondes, selon la configuration de l’écouteur et l’adaptation réalisée.
La commercialisation débute aux États-Unis le 24 août 2026. Selon les déclarations de la direction de Sonova relayées par la presse économique, l’Australie et les principaux marchés européens — Allemagne, France, Italie et Royaume-Uni — suivent à la mi-septembre 2026, avant un déploiement plus large.
Cette génération succède à la plateforme Audéo Infinio Sphere, dont nous avions détaillé le lancement aux États-Unis, et confirme l’orientation que nous anticipions dans notre analyse des innovations attendues de la prochaine plateforme Phonak. Elle poursuit une évolution de fond de l’audioprothèse contemporaine : l’exécution de réseaux neuronaux directement dans l’aide auditive, en temps réel.
La gamme Audéo EON
La gamme Audéo EON reprend la nomenclature habituelle de Phonak. Les modèles Audéo EON Sphere, équipés de la puce HYPERSONIC dédiée au traitement neuronal Spheric Speech Clarity 3.0, sont proposés dans les niveaux E90-Sphere et E70-Sphere. La gamme Audéo EON R conventionnelle est plus largement déclinée, avec les niveaux E90-R, E70-R, E50-R et E30-R.
Gamme Phonak Audéo EON : modèles et niveaux de technologie
| Modèle | Niveau de gamme | Puce HYPERSONIC et Spheric Speech Clarity 3.0 | Positionnement |
|---|---|---|---|
| Phonak Audéo E90-Sphere | Premium | Oui | Version Sphere la plus complète |
| Phonak Audéo E70-Sphere | Avancé | Oui | Version Sphere intermédiaire |
| Phonak Audéo E90-R | Premium | Non | EON classique haut de gamme |
| Phonak Audéo E70-R | Avancé | Non | EON classique niveau avancé |
| Phonak Audéo E50-R | Standard | Non | EON classique niveau intermédiaire |
| Phonak Audéo E30-R | Essentiel | Non | Entrée de gamme EON |
| Phonak CROS EON R | CROS | Non | Surdité unilatérale ou oreille non appareillable |
Tous les modèles de la gamme sont rechargeables. Le niveau de gamme conditionne le nombre de fonctions automatiques disponibles, mais ne détermine pas à lui seul le résultat obtenu : celui-ci dépend aussi du couplage acoustique, du réglage et du suivi.

La puce HYPERSONIC : ce que change un processeur dédié à l’IA
Au cœur d’Audéo EON Sphere se trouve une nouvelle puce baptisée HYPERSONIC. Il s’agit d’un processeur spécifiquement consacré aux calculs nécessaires au traitement de la parole et du bruit par intelligence artificielle.
Selon Sonova, cette architecture permet à Spheric Speech Clarity 3.0 de fonctionner avec une consommation énergétique réduite de 37 % par rapport à la génération Sphere précédente. Ce gain de rendement a des conséquences directes sur le dispositif lui-même :
- un appareil annoncé 25 % plus petit que son prédécesseur ;
- un poids 20 % inférieur ;
- jusqu’à 38 heures d’autonomie, selon les conditions d’utilisation.
Ces valeurs sont des caractéristiques communiquées par le fabricant, mesurées dans ses propres conditions d’essai. Elles ne constituent pas les résultats d’une évaluation clinique indépendante, et l’autonomie réelle varie fortement selon la perte auditive, le niveau de gain programmé, le temps passé en environnement bruyant et l’usage du streaming.
Pourquoi la miniaturisation est un vrai sujet technique
Les traitements par réseaux neuronaux sont gourmands en calcul. L’enjeu industriel consiste à concilier trois contraintes qui s’opposent : la puissance de traitement, la consommation électrique et la taille de l’appareil. Sur les premières générations Sphere, le mode de traitement neuronal le plus exigeant réduisait sensiblement l’autonomie lorsqu’il restait actif longtemps. L’amélioration du rendement de la puce est donc autant un progrès de confort d’usage qu’un progrès de performance.

Recharge et autonomie : les chargeurs de la plateforme EON
Phonak accompagne EON de deux solutions de recharge dédiées. Le Charger RIC E est le chargeur filaire standard, compatible avec les Audéo E-Sphere, Audéo E-R et CROS E-R. Le ChargerGo RIC I E embarque sa propre batterie et permet, selon le fabricant, jusqu’à trois recharges complètes des appareils sans accès au secteur — un avantage réel en voyage, en déplacement professionnel ou lors d’une journée passée hors du domicile.
Gamme EON : solutions de recharge
| Chargeur | Compatibilité | Batterie intégrée | Temps de charge complet | Usage |
|---|---|---|---|---|
| Phonak Charger RIC E | Audéo E-Sphere, Audéo E-R, CROS E-R | Non — alimentation secteur | Environ 2 h 30 | Domicile |
| Phonak ChargerGo RIC I E | Audéo E-Sphere, Audéo E-R, CROS E-R | Oui — jusqu’à 3 recharges complètes | Environ 2 h 30 | Voyage et mobilité |
Côté autonomie, Phonak annonce jusqu’à 38 heures pour Audéo EON Sphere et Audéo EON R, et jusqu’à 20 heures pour le CROS EON R. L’écart s’explique par la taille du boîtier et par le fonctionnement du système CROS, qui transmet en permanence un flux audio vers l’oreille appareillée.
Ces durées sont des valeurs constructeur. L’autonomie réelle dépend du niveau d’amplification programmé, du temps de streaming, de la sollicitation des traitements de réduction du bruit — le mode neuronal étant le plus consommateur — et du vieillissement progressif de la batterie. C’est un paramètre à observer pendant la période d’essai, dans vos propres conditions d’usage, plutôt que sur une fiche technique.
Phonak indique par ailleurs que les batteries lithium-ion intégrées sont testées pour une durée de vie de six ans, et que les appareils bénéficient d’un indice de protection IP68 contre l’eau et la poussière. La durée annoncée provient d’un test de capacité accéléré réalisé en laboratoire à température ambiante : c’est un ordre de grandeur, pas une garantie contractuelle.
Un point mérite d’être connu avant l’achat : un appareil rechargeable n’a pas de pile à changer, mais sa batterie intégrée n’est pas remplaçable par l’utilisateur. C’est un arbitrage à évaluer avec votre audioprothésiste — les difficultés de dextérité ou de vision plaidant au contraire très fortement en faveur du rechargeable.

Phonak EON Sphere et Spheric Speech Clarity 3.0 : mieux extraire la parole du bruit
Audéo EON Sphere introduit Spheric Speech Clarity 3.0, troisième génération du traitement neuronal propriétaire de Phonak. Son principe est de séparer la parole du bruit tout autour de l’utilisateur, et pas uniquement lorsque l’interlocuteur se trouve exactement face à lui — ce qui la distingue d’un microphone directionnel classique.
Sonova annonce, sur la base de ses études internes, une amélioration de la compréhension de la parole et une réduction de l’effort d’écoute par rapport aux mêmes appareils sans cette fonction. Ces éléments proviennent de Field Study News publiées par le fabricant : ils décrivent une tendance cohérente avec la littérature publiée, mais devront être confirmés par des travaux conduits hors du cadre industriel et dans des conditions proches de la vie réelle.
Une réserve à connaître sur la preuve avancée
Phonak annonce que Spheric Speech Clarity rend l’utilisateur « deux fois plus susceptible de comprendre chaque mot, quelle que soit la direction ». Cette affirmation mérite d’être lue attentivement : dans le communiqué de lancement, elle renvoie à une Field Study News publiée en 2024, c’est-à-dire à une étude portant sur la première génération de la technologie, et non sur la version 3.0 lancée aujourd’hui. La comparaison y est faite avec les mêmes appareils réglés à l’identique mais sans la fonction activée.
Autrement dit, le bénéfice du principe est documenté ; le gain propre à la troisième génération par rapport à la deuxième ne l’est pas encore publiquement. Seul le communiqué relatif à AutoSense OS AI 8.0 s’appuie sur un document de 2026 comparant explicitement à la génération précédente.
Ce que fait un réseau neuronal, et ce qu’il ne fait pas
Le problème central de l’audioprothèse n’est pas d’amplifier les sons : c’est d’extraire une parole utile d’un environnement acoustique complexe. Dans un restaurant, plusieurs voix, des bruits de vaisselle, de la musique et de la réverbération arrivent simultanément aux microphones. Une amplification conventionnelle ne suffit pas à restaurer une bonne intelligibilité : le système doit identifier les caractéristiques temporelles et spectrales qui correspondent vraisemblablement à la parole, et atténuer celles qui appartiennent aux bruits concurrents.
Les deep neural networks, ou réseaux neuronaux profonds, abordent ce problème autrement que les algorithmes classiques de réduction du bruit. Ils sont entraînés sur un très grand nombre de situations acoustiques afin d’apprendre à différencier statistiquement les composantes du signal qui relèvent de la parole de celles qui relèvent du bruit.
Que dit la littérature scientifique sur l’IA dans les appareils auditifs ?
C’est la question qui compte, et elle mérite d’être traitée séparément des communiqués. Trois travaux récents permettent de situer le niveau de preuve réel de cette classe de traitements.
Une étude sur 20 adultes appareillés
Une étude publiée en 2026 dans Trends in Hearing a porté sur 20 adultes présentant une surdité neurosensorielle légère à modérément sévère. Elle a comparé quatre réglages combinant directivité microphonique — omnidirectionnelle ou faisceau directionnel — et réduction du bruit — désactivée, classique ou par réseau neuronal.
Le traitement par réseau neuronal associé au beamforming a obtenu les meilleurs résultats sur l’ensemble des critères : reconnaissance vocale, clarté perçue, impression globale et effort d’écoute. Deux nuances importantes ressortent : le bénéfice était plus net dans un bruit stationnaire que dans un brouhaha de plusieurs locuteurs, et la directivité restait particulièrement utile quand la parole venait de face. Autrement dit, le réseau neuronal ne remplace pas la directivité, il s’y ajoute.
Une évaluation objective sur 1 152 enregistrements
Une seconde publication, parue en 2025 dans la même revue, a analysé 1 152 enregistrements réalisés sur un mannequin acoustique KEMAR équipé de cinq audiogrammes différents, dans des salles réverbérantes et non réverbérantes. L’intelligibilité a été estimée par un modèle de calcul, et non mesurée chez des auditeurs — c’est une limite méthodologique à garder à l’esprit.
Les résultats confirment l’avantage du traitement neuronal associé au beamforming, avec les gains les plus marqués à des rapports signal/bruit de 0 et +5 dB, un bénéfice modéré à −5 dB en faible réverbération, et aucun bénéfice en réverbération moyenne.
Ce dernier point est décisif : aucun algorithme ne supprime les contraintes physiques de l’acoustique. Une grande salle réverbérante, plusieurs locuteurs simultanés ou une distance importante entre le patient et son interlocuteur restent des situations exigeantes, quelle que soit la génération d’appareils.
Une confirmation neurophysiologique
Une troisième étude, publiée en 2026 dans Hearing Research, a cherché une preuve objective au niveau cortical. Chez 17 adultes âgés porteurs d’une surdité neurosensorielle, l’activation du traitement neuronal dans le bruit a restauré une réponse de mismatch negativity — un marqueur électroencéphalographique de détection automatique d’un changement sonore — qui était pratiquement absente sans ce traitement.
Cette approche est intéressante parce qu’elle ne repose pas sur le ressenti du patient. Elle suggère que, dans cette situation expérimentale, le débruitage neuronal améliore la représentation cérébrale d’un contraste phonémique dans le bruit, et pas seulement le confort déclaré par le patient. L’effectif reste limité et le protocole éloigné d’une conversation réelle : c’est un argument de mécanisme, pas une preuve de bénéfice conversationnel au quotidien.
Une réserve méthodologique à connaître
Ces trois publications comptent parmi leurs auteurs des collaborateurs de Sonova, société qui développe la technologie évaluée. Cela ne les disqualifie pas — elles sont publiées dans des revues à comité de lecture et leurs méthodes sont décrites — mais cela impose de les lire comme des travaux réalisés en partie par le fabricant. Une évaluation entièrement indépendante, sur des effectifs plus larges et en situation écologique, reste à produire.
À l’inverse, une étude publiée en 2023 dans Scientific Reports, conduite par une équipe berlinoise indépendante de Sonova, avait montré qu’un algorithme de débruitage par IA et apprentissage profond pouvait ramener l’intelligibilité de patients appareillés au niveau de témoins normo-entendants. Elle fonctionnait toutefois sur un ordinateur portable et sur un seul microphone : elle démontrait le potentiel du principe, pas la performance d’un appareil commercialisé.
Pourquoi la gêne dans le bruit ne se lit pas sur l’audiogramme
Les difficultés de compréhension dans le bruit constituent la plainte la plus fréquente des personnes appareillées. Elles ne se résument pas à une élévation des seuils audiométriques et résultent de plusieurs mécanismes distincts :
- une diminution de la sélectivité fréquentielle cochléaire, qui brouille la séparation des sons proches en fréquence ;
- une altération de la résolution temporelle, qui dégrade la perception des transitions rapides de la parole ;
- la perte de certaines informations binaurales utiles à la localisation et à la séparation des sources ;
- l’existence possible de zones mortes cochléaires, sur lesquelles l’amplification n’apporte rien ;
- une augmentation de la charge cognitive nécessaire pour reconstituer le message.
Ce point n’est pas théorique pour notre réseau : il correspond à un axe de travail que nous menons depuis plusieurs années avec le service ORL de l’hôpital Bicêtre. Marc Boulet est premier auteur d’une communication présentée à la SFORL consacrée à l’appareillage de patients présentant des seuils auditifs normaux selon le BIAP mais une intelligibilité dégradée dans le bruit — précisément les personnes à qui l’on répond parfois que « l’audiogramme est normal ».
Un travail antérieur, publié dans Clinical Otolaryngology en 2019 avec l’équipe de Bicêtre, avait montré qu’un audiogramme haute définition met en évidence des micro-pertes auditives invisibles sur l’audiogramme conventionnel, et qu’il existe une corrélation étroite entre la fréquence de ces micro-pertes et celle de l’acouphène associé. C’est la raison pour laquelle nos centres pratiquent l’audiométrie vocale dans le bruit et, lorsque la situation le justifie, l’audiométrie haute définition : un audiogramme tonal normal n’exclut pas une gêne auditive réelle.
La réduction du bruit par intelligence artificielle cherche donc moins à « mieux amplifier » qu’à présenter au système auditif un signal dont le rapport entre parole utile et bruit est plus favorable. Cette distinction explique pourquoi les progrès du traitement numérique du signal peuvent modifier le vécu quotidien même lorsque les performances mesurées en cabine restent identiques — un phénomène que nous avions abordé à propos de la manière dont les appareils auditifs récents s’adaptent au cerveau.
WindBlock 2.0 : le bruit du vent, un problème longtemps négligé
La nouvelle génération inaugure également WindBlock 2.0. Le bruit du vent constitue une difficulté particulière : les turbulences créées au niveau des microphones produisent un bruit de basse fréquence et de forte amplitude, capable de masquer entièrement la parole.
Sonova annonce que WindBlock 2.0 réduit ce bruit jusqu’à 50 dB par rapport à la fonction désactivée. Le fabricant annonce également une amélioration du rapport signal/bruit pouvant atteindre 30 dB dans ces conditions. Il s’agit de mesures techniques réalisées par Phonak, dans des conditions expérimentales définies : elle ne signifie pas qu’un patient obtiendra systématiquement 50 dB de réduction en situation réelle. Elle témoigne néanmoins d’une attention nouvelle portée à des environnements longtemps mal traités : marche en extérieur, vélo, randonnée, terrasse, conversation par temps venteux.
Auracast : une évolution de la connectivité, pas seulement du son
Audéo EON est compatible avec Auracast Broadcast Audio. Auracast repose sur le Bluetooth LE Audio et permet à une source sonore de diffuser son flux simultanément vers un nombre illimité de récepteurs compatibles.
Pour une personne malentendante, cela ouvre progressivement la possibilité de recevoir directement dans ses aides auditives le son d’une télévision, les annonces d’un lieu public, une conférence, un spectacle ou le signal audio d’un musée. Le déploiement dépend toutefois de l’équipement des lieux : la compatibilité de l’appareil est une condition nécessaire, pas suffisante.
Phonak réunit sous le terme de connectivité « Made-For-All » trois canaux dans un même appareil : le Bluetooth Classic, qui assure la compatibilité avec un très large parc de smartphones, RogerDirect pour les microphones déportés Roger, et Auracast. Les microphones Roger restent, en pratique, l’une des solutions les plus efficaces pour la parole à distance, en réunion ou en classe.
Le lancement s’accompagne enfin de deux nouvelles solutions de charge, dont un chargeur portable à batterie intégrée, et d’une mise à jour des applications myPhonak et myPhonak Junior — cette dernière concernant le suivi des enfants appareillés.
CROS EON R : surdité unilatérale et pertes très asymétriques
La gamme comprend CROS EON R, destiné aux situations où une oreille ne peut pas être appareillée de façon conventionnelle. Le principe d’un système CROS est de capter les sons du côté sourd et de les transmettre à l’oreille qui entend ; en BiCROS, cette oreille reçoit en plus sa propre amplification.
C’est un domaine sur lequel notre réseau travaille et publie. Marc Boulet a participé à une communication présentée aux Assises de la Face et du Cou consacrée à l’Active Tri-CROS, un système qui permet d’amplifier simultanément la plus mauvaise oreille tout en conservant le transfert controlatéral, dans les pertes sévèrement asymétriques. Ce type de configuration illustre bien une réalité de terrain : le choix entre CROS, BiCROS et système à conduction osseuse ne se déduit pas d’un audiogramme, il se construit avec des essais comparatifs.
Lorsque l’oreille atteinte relève plutôt d’une solution osseuse, d’autres voies existent, qu’il s’agisse de la conduction osseuse non chirurgicale ou des systèmes implantables, comme la génération Cochlear Baha 7. Marc Boulet est également premier auteur d’une communication comparant le système Osia à la Baha Attract, et co-auteur de l’étude correspondante publiée en 2023 dans les European Archives of Oto-Rhino-Laryngology, qui a documenté chez des patients convertis un gain fonctionnel significatif dans les hautes fréquences et sur la parole dans le bruit.
L’appareillage : ce que la puce ne fait pas à votre place
C’est le point le plus important de cette page, et celui que les communiqués de lancement traitent le moins. L’arrivée d’algorithmes plus sophistiqués ne diminue en rien l’importance de l’adaptation audioprothétique — elle l’augmente, parce que le nombre de paramètres à arbitrer augmente lui aussi.
Deux patients présentant un audiogramme tonal similaire peuvent avoir des performances très différentes en compréhension vocale, en tolérance aux sons forts, en besoins de communication ou en écoute dans le bruit. Le résultat final dépend d’une chaîne de décisions dont l’appareil n’est qu’un maillon.
Ce qui se joue réellement lors d’un appareillage
- Le choix de l’appareil et du niveau de gamme. Un EON Sphere n’est pas systématiquement le bon choix : la puce neuronale n’apporte un bénéfice décisif que si la personne passe réellement du temps dans des environnements bruyants complexes.
- Le choix de l’écouteur et de sa puissance. Un écouteur insuffisamment dimensionné limite la réserve de gain et le niveau de sortie disponibles, notamment dans les fréquences nécessaires à l’audibilité des indices de parole.
- Le couplage acoustique. Dôme ouvert, dôme fermé ou embout sur mesure : c’est ce qui conditionne l’occlusion, la restitution des graves et l’efficacité réelle du débruitage. Un embout inadapté annule une partie du bénéfice attendu du traitement neuronal.
- La programmation des gains selon une méthodologie de calcul, puis son ajustement à la tolérance de la personne.
- La vérification électroacoustique, mesure objective de ce que l’appareil délivre réellement dans le conduit auditif — et non de ce que le logiciel prévoit.
- L’évaluation de la compréhension vocale, dans le silence puis dans le bruit, qui est la seule manière de savoir si le réglage fonctionne.
- Le réglage de la directivité et des algorithmes de réduction du bruit, dont l’automatisme doit être adapté au mode de vie et non laissé par défaut.
- Le suivi dans les conditions réelles d’utilisation, avec des ajustements successifs sur plusieurs semaines.
Chez Audition Marc Boulet, l’intérêt d’une nouvelle génération d’aides auditives s’évalue au regard du profil auditif et des difficultés fonctionnelles de la personne, pas sur la seule présence du terme « intelligence artificielle » dans une brochure. Notre réseau intervient sur l’ensemble des configurations d’appareillage, des appareils auditifs conventionnels aux situations plus complexes : appareillage sur oreille chronique ou opérée, embouts ventilés, systèmes CROS et BiCROS, conduction osseuse chirurgicale et non chirurgicale, réglage des processeurs d’implants, et appareillage pédiatrique.
Cette expertise s’appuie sur une activité de publication et d’enseignement continue. Marc Boulet enseigne à l’école d’audioprothèse de Bordeaux et intervient dans le DIU de chirurgie de l’oreille moyenne de l’université Paris-Saclay destiné aux ORL ; il présente régulièrement des travaux au congrès des audioprothésistes et aux Assises ORL de la Face et du Cou. Nous suivons également de près l’évolution du marché, comme lors de notre synthèse des 20 innovations majeures du congrès 2026 ou de l’analyse d’autres plateformes fondées sur l’IA, telles que Starkey Omega AI.
La question du renouvellement
Faut-il changer d’appareils pour passer à EON ? Pas nécessairement. L’intérêt d’un renouvellement dépend de l’ancienneté de l’équipement, des performances réellement obtenues avec les appareils actuels, des difficultés qui persistent malgré un réglage optimisé et des besoins de communication de la personne.
Un appareil récent mal réglé donne de moins bons résultats qu’un appareil de génération précédente correctement adapté et suivi. Une comparaison audioprothétique individualisée, avec essai, est toujours préférable à un changement motivé par la seule sortie d’une nouvelle plateforme. Les questions de budget et de prise en charge se posent également : la période de renouvellement ouvrant droit au remboursement est encadrée, et les prix des appareils auditifs varient sensiblement d’une classe et d’une gamme à l’autre.
Audéo EON constitue-t-il une rupture technologique ?
Il est trop tôt pour conclure, et c’est une réponse honnête plutôt qu’une prudence de façade.
Sur le plan de l’architecture électronique, la multiplication des processeurs spécialisés capables d’exécuter des réseaux neuronaux directement dans une aide auditive constitue une évolution réelle. La littérature scientifique récente montre par ailleurs que le débruitage par apprentissage profond améliore la perception vocale dans certaines configurations, et plusieurs travaux convergent sur ce point — étant entendu que la majorité d’entre eux associent des chercheurs du fabricant.

En revanche, les chiffres de performance propres à Audéo EON publiés lors du lancement proviennent de Phonak et de Sonova. Une évaluation rigoureuse nécessitera des études conduites hors du cadre industriel, sur des effectifs plus larges, avec des comparaisons entre plusieurs technologies concurrentes, des mesures en situation écologique et un suivi de la satisfaction des patients au quotidien.
La question la plus utile n’est finalement pas de savoir si EON contient « plus d’IA », mais dans quelles situations précises cette puissance de calcul supplémentaire apporte un bénéfice perceptif mesurable pour une personne donnée. C’est exactement ce qu’un essai comparatif en centre permet de déterminer.
Faire le point sur votre audition
Si vous vous demandez si une nouvelle génération d’appareils changerait quelque chose pour vous, la seule manière de le savoir est de mesurer votre gêne réelle, en particulier dans le bruit. Un dépistage auditif est réalisé sans engagement dans nos centres, et un essai comparatif permet de confronter plusieurs solutions dans vos propres situations d’écoute.
Trouvez le centre Audition Marc Boulet le plus proche de chez vous pour prendre rendez-vous avec un audioprothésiste.
À retenir
- Phonak Audéo EON a été lancé le 24 août 2026 aux États-Unis ; la France est annoncée pour la mi-septembre 2026.
- La gamme comprend EON Sphere avec puce IA dédiée, EON R doté d’AutoSense OS AI 8.0, et CROS EON R pour les surdités unilatérales ; Sphere et R sont annoncés pour des pertes légères à profondes.
- Les chiffres de 37 % d’économie d’énergie, 25 % de réduction de taille, 20 % de poids en moins, 38 heures d’autonomie et 50 dB de réduction du bruit du vent sont des données constructeur, non des résultats d’essais indépendants.
- La littérature scientifique récente montre un bénéfice du débruitage neuronal associé à la directivité dans certaines configurations ; plusieurs de ces travaux impliquent toutefois des chercheurs affiliés à Sonova, et une confirmation indépendante reste nécessaire.
- Une gêne dans le bruit peut exister avec un audiogramme tonal normal : elle se met en évidence par une audiométrie vocale dans le bruit.
- Le bénéfice réel dépend autant du couplage acoustique, du réglage, de la vérification et du suivi que de la puce elle-même.
- Un renouvellement ne se décide pas sur la sortie d’une plateforme, mais sur les difficultés qui persistent malgré un réglage optimisé.
Sources
- Sonova Holding AG. Sonova strengthens innovation leadership with Phonak EON portfolio and third-generation proprietary real-time AI. Communiqué Groupe, Stäfa, 24 août 2026.
- Phonak. New EON hearing aid portfolio strengthens Phonak’s leadership in speech understanding, scene intelligence and Made-For-All connectivity. Communiqué, Stäfa, 24 août 2026.
- Folkeard P, Ashkanichenarlogh V, Rahme M, Parsa V, Kühnel V, Sheikh B, Qian J, Sung YY, Scollie S. The Effect of Deep Neural Network Implementation on Speech Recognition, Listening Effort, and Sound Quality in Older Adults With Mild to Moderately Severe Hearing Loss. Trends Hear. 2026;30:23312165261449983. doi:10.1177/23312165261449983 — PMID 42125824.
- Ashkanichenarlogh V, Folkeard P, Scollie S, Kühnel V, Parsa V. Objective Evaluation of a Deep Learning-Based Noise Reduction Algorithm for Hearing Aids Under Diverse Fitting and Listening Conditions. Trends Hear. 2025;29:23312165251396644. doi:10.1177/23312165251396644 — PMID 41289071.
- Huang W, Zheng Y, Kühnel V, Launer S, Ding H, Guan J. Restoring auditory discrimination in noise: mismatch negativity evidence for a deep neural network-based denoising system in hearing aids. Hear Res. 2026;476:109635. doi:10.1016/j.heares.2026.109635 — PMID 41985304.
- Diehl PU, Singer Y, Zilly H, Schönfeld U, Meyer-Rachner P, Berry M, Sprekeler H, Sprengel E, Pudszuhn A, Hofmann VM. Restoring speech intelligibility for hearing aid users with deep learning. Sci Rep. 2023;13:2719. doi:10.1038/s41598-023-29871-8 — PMID 36792797.
- Nevoux J, Boulet M, Pronost N, Papon JF, Alexandru M. Performance of an active transcutaneous bone conduction implant, the Osia system, in high frequencies and hearing in noise in users converted from a Baha Attract system: a prospective study. Eur Arch Otorhinolaryngol. 2023;280:4691-4696. doi:10.1007/s00405-023-08149-9.
- Lefeuvre J, Chedeau J, Boulet M, Fain G, Papon JF, Nguyen Y, Nevoux J. Hidden hearing loss and tinnitus: utility of the high-definition audiograms in diagnosis. Clin Otolaryngol. 2019;44:1170-1175. doi:10.1111/coa.13435.
- Boulet M, Chedeau J, Lefeuvre J, Fain G, Timsit A, Veleur M, Papon JF, Nevoux J. Appareillage des patients avec seuils auditifs normaux selon le BIAP et intelligibilité dégradée dans le bruit. Communication, SFORL 2023 / Assises de la Face et du Cou, recueil « Études scientifiques n° 5 ».
- Lefeuvre J, Gargula S, Boulet M, Potier M, Ayache D, Daval M. Active Tri-CROS : amplification concomitante de la plus mauvaise oreille avec les systèmes CROS et BiCROS pour les pertes auditives sévèrement asymétriques. Communication, SFORL 2023 / Assises de la Face et du Cou, recueil « Études scientifiques n° 5 ».
Rédaction et mise à jour
Rédaction : Marc Boulet, audioprothésiste diplômé d’État, Audition Marc Boulet.
Dernière mise à jour : 24 août 2026.
Questions fréquentes sur Phonak Audéo EON
Quand Phonak EON sera-t-il disponible en France ?
Le lancement a débuté aux États-Unis le 24 août 2026. Selon les déclarations de Sonova relayées par la presse économique, l’Australie et les principaux marchés européens — dont la France — suivent à la mi-septembre 2026. Nos audioprothésistes pourront vous indiquer la disponibilité effective à l’essai dès que les appareils seront référencés. Trouvez votre centre Audition Marc Boulet.
Quelle est la différence entre Phonak EON et Infinio Sphere ?
EON Sphere introduit une nouvelle puce, HYPERSONIC, et la troisième génération du traitement neuronal Spheric Speech Clarity. Sonova annonce une consommation énergétique réduite de 37 %, un appareil 25 % plus petit et 20 % plus léger que la génération Sphere précédente, ainsi qu’une autonomie pouvant atteindre 38 heures. Ces valeurs sont des données constructeur, mesurées dans ses propres conditions d’essai.
Phonak EON utilise-t-il réellement l’intelligence artificielle ?
Oui, au sens technique du terme. EON Sphere exécute un réseau neuronal profond sur un processeur dédié, en temps réel, pour séparer la parole du bruit environnant. Il ne s’agit pas d’une simple classification automatique de l’environnement sonore, mais d’un traitement du signal appliqué en continu. Les modèles sans puce dédiée, comme EON R, conservent un traitement conventionnel.
À quoi sert Spheric Speech Clarity 3.0 ?
Cette technologie vise à extraire la parole dans les environnements bruyants, y compris lorsque plusieurs voix proviennent de directions différentes. C’est ce qui la distingue d’un microphone directionnel classique, qui privilégie ce qui vient de face. Elle ne remplace pas la directivité : les études disponibles montrent que le meilleur résultat s’obtient en combinant les deux.
L’intelligence artificielle améliore-t-elle vraiment les appareils auditifs ?
Plusieurs travaux publiés en 2025 et 2026 montrent qu’un débruitage par réseau neuronal associé à la directivité améliore la reconnaissance vocale et réduit l’effort d’écoute chez des adultes malentendants. Ce bénéfice n’est cependant pas constant : il est le plus net à des rapports signal/bruit modérés et s’atténue, voire disparaît, lorsque la réverbération de la pièce augmente. Aucun algorithme ne supprime les contraintes physiques de l’acoustique.
Quelle est l’autonomie réelle d’Audéo EON Sphere ?
Phonak annonce jusqu’à 38 heures. Cette valeur correspond à un usage de référence défini par le fabricant. L’autonomie réelle dépend de la perte auditive, du gain programmé, du temps passé en environnement bruyant — le traitement neuronal étant le mode le plus consommateur — et de l’usage du streaming Bluetooth. C’est un point à vérifier pendant la période d’essai, pas sur une fiche technique.
Audéo EON est-il compatible avec Auracast ?
Oui, la plateforme EON intègre la compatibilité Auracast Broadcast Audio, qui permet de recevoir directement dans les aides auditives un flux audio diffusé par une source compatible : téléviseur, salle de conférence, lieu public. Le bénéfice dépend toutefois de l’équipement du lieu en émetteurs Auracast, encore inégal en France.
EON peut-il convenir à une surdité unilatérale ?
La gamme comprend CROS EON R, conçu pour les situations où l’oreille atteinte ne peut pas bénéficier d’une amplification conventionnelle : un microphone capte les sons du côté sourd et les transmet à l’oreille qui entend. D’autres solutions existent selon le type de surdité, notamment les systèmes à conduction osseuse. Le choix se construit par essais comparatifs, pas à partir du seul audiogramme, et suppose au préalable un avis ORL sur la cause de la surdité.
Faut-il changer ses appareils auditifs pour passer à EON ?
Pas nécessairement. L’intérêt d’un renouvellement dépend de l’ancienneté de l’équipement, des performances obtenues avec les appareils actuels, des difficultés qui persistent malgré un réglage optimisé et des besoins de communication. Un appareil récent mal réglé donne de moins bons résultats qu’un appareil de génération précédente correctement adapté. Les conditions de prise en charge et le tiers payant entrent également dans la décision.
J’ai un audiogramme normal mais je ne comprends pas dans le bruit : un appareil comme EON peut-il m’aider ?
C’est une situation fréquente et longtemps mal reconnue. Une gêne dans le bruit peut exister avec des seuils tonaux normaux, en raison de micro-pertes auditives ou d’une altération du traitement temporel que l’audiogramme classique ne met pas en évidence. Marc Boulet est premier auteur d’une communication présentée à la SFORL consacrée précisément à l’appareillage de ces patients. La première étape n’est pas de choisir un appareil, mais de réaliser une audiométrie vocale dans le bruit afin d’objectiver la gêne. Ce sujet concerne aussi les jeunes adultes, chez qui la plainte est souvent attribuée à tort à un manque d’attention.